Fedify #951 : failure 벤치마크 Flaky Test와 가상 시계로 고치기
Fedify 벤치마크 failure 시나리오 테스트가 25ms duration과 CI 스케줄링 때문에 Flaky해지는 이유를 정리하고, Clock 주입으로 시간 의존성을 제거한 수정 과정을 담습니다.

#951 이슈 이해하기
이 이슈는 벤치마크의 failure 시나리오를 검증하는 자동 테스트 자체에 대한 이슈이기 때문에 벤치마크에 대한 이해를 선행하고 들어가면 좋습니다.
벤치마크(Benchmark)란?
벤치마크(benchmark)는 정해진 조건으로 프로그램에 일을 시키고, 그때의 처리 속도와 결과를 측정하는 테스트입니다.
예를 들어 같은 요청을 여러 번 보내고, ‘얼마나 처리했는지, 얼마나 걸렸는지, 실패는 어떻게 처리되었는지’를 관찰합니다.
Fedify can run as a cooperative benchmark target, and the fedify bench command drives ActivityPub-specific load against it to measure federation workloads without requiring an external metrics backend.
 fedify.dev

Fedify의 fedify bench 명령은 benchmarkMode가 켜진 대상 서버에 ActivityPub 부하를 걸고,
’지연, 처리량, 성공률, 오류’를 모아 보고하는 벤치마크 클라이언트입니다.
YAML 스위트(suite)로 시나리오를 정의하며, 클라이언트는 합성 원격 액터처럼 서명된 전달을 보내거나
/.well-known/fedify/bench/trigger를 호출해 대상의 sendActivity(), 큐 경로를 재현합니다.
1. 무엇을 확인하는 것인가?
shares sink base across remote fault mix
이 문장의 뜻은 ‘서로 다른 원격 오류 시나리오’가 같은 수신함 주소의 기준점(sinkBase)을 쓰는지 확인한다는 것입니다.
여기서 ‘서로 다른 원격 오류 시나리오’란, 테스트의 대상이 되는 서버가 발신하는 쪽이 되어서, 상대방의 수신함으로 전달하려 할 때 만나는 두 원격 결함 유형을 말합니다.
fault: ["remote-404", "remote-410"];remote-404: 원격 수신함이 404(Not Found)를 반환remote-410: 원격 수신함이 410(Gone)을 반환
const sinkBase = `http://127.0.0.1:${await reservePort()}/`;sinkBase는 벤치마크용 가짜 수신함(inbox) 주소들을 만들 때 사용하는 기준 URL입니다.
테스트에서 이것을 다루는 이유는 remote-404와 remote-410 요청이 서로 다른 inbox를 쓰더라도, 둘 다 설정한 동일한 기준 URL 아래에 만들어지는지 확인하려는 것입니다.
예를 들어 포트가 9000이면, 러너는 이를 바탕으로 주소들을 만듭니다.
sinkBase : http://127.0.0.1:9000/
수신함 1 : http://127.0.0.1:9000/inbox/0
수신함 2 : http://127.0.0.1:9000/inbox/1
여기서 수신함은 테스트 대상 서버가 메시지를 보낼 목적지입니다.
러너가 대상 서버의 /trigger에 ‘이 주소의 수신함으로 보내라’고 전달하면, 대상 서버가 발신 전달을 시도하고, 벤치마크용 수신함이 설정된 404 또는 410으로 응답하는 흐름입니다.
Fedify 문서에서는 고정된 sinkBase를 쓰면 대상 서버가 수신함 URL을 미리 triggerSinks에 등록해 허용할 수도 있다고 설명합니다.
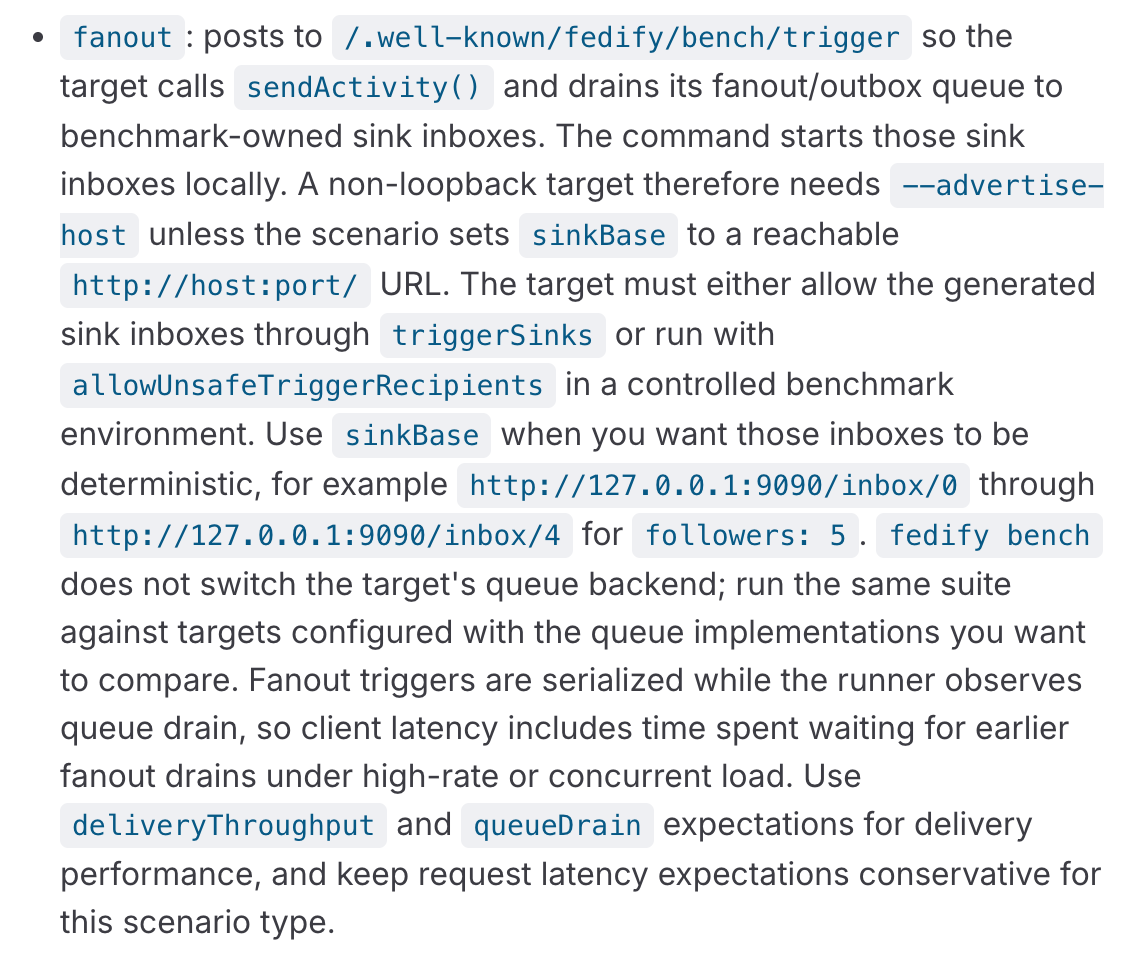
위 문장을 순서대로 풀면 다음과 같습니다.
fedify bench가 벤치마크용 수신함 서버를 띄웁니다.- 러너가 대상 서버의
/.well-known/fedify/bench/trigger에 ‘이 수신함으로 활동을 보내라’고 요청합니다. - 대상 서버는
sendActivity()를 호출해 발신 큐 경로로 전달합니다. - 이때 대상 서버는 요청에 적힌 수신함 URL이 자신의
triggerSinks허용 목록에 있는지 확인합니다.
즉,
sinkBase = http://127.0.0.1:9090/- 러너가 생성하는 수신함
http://127.0.0.1:9090/inbox/0http://127.0.0.1:9090/inbox/1
- 대상 서버의
triggerSinks: 위 수신함 URL들을 허용 목록에 등록
sinkBase 덕분에 생성될 주소를 실행 전에 알 수 있으므로, 대상 서버의 triggerSinks에 생성될 수신함 URL 각각 설정할 수 있다는 뜻입니다.
2. 어떤 요청을 실행하나?
앞서 살펴봤다시피 시나리오에는 두 원격 결함이 들어 있습니다.
fault: ["remote-404", "remote-410"];벤치마크 대상에게 ‘이 수신함으로 메시지를 보내 봐’라고 요청했을 때, 수신함 측에서 각각 HTTP 404와 410 같은 예상된 실패 상황을 시험하는 것입니다.
여기서 중요한 점은 실패 응답 자체가 테스트 목적이라는 것입니다.
즉, Fedify의 failure 시나리오에서 성공은 예측한 실패를 관찰했다는 의미입니다.
3. 테스트가 주소를 어떻게 기록하는가?
이 부분은 실제 HTTP 서버를 호출하는 대신 테스트가 만든 fetch 함수를 사용합니다.
코드를 통해 알아보겠습니다.
if (url.pathname === "/.well-known/fedify/bench/trigger") {
  triggerCalls++;
  const body = JSON.parse(String(init?.body));
  recipientInboxes.push(body.recipients[0].inbox);
  return Promise.resolve(statsJson({ version: 1 }, 202));
}
/trigger 요청이 올 때마다
triggerCalls를 1 증가시킵니다.- 요청 본문에서 첫 번째 수신함 주소를 읽습니다.
- 그 주소를
recipientInboxes배열에 저장합니다. - 대상 서버가 요청을 접수한 것처럼
202(Accepted)응답을 돌려줍니다.
즉, 나중에 recipientInboxes를 보면 러너가 실제로 어떤 수신함 URL을 만들어 요청했는지 알 수 있습니다.
4. 왜 최소 두 번이 필요할까?
마지막 검증을 보면 두 주소가 모두 등장해야 합니다.
assert.ok(recipientInboxes.includes(new URL("/inbox/0", sinkBase).href));
assert.ok(recipientInboxes.includes(new URL("/inbox/1", sinkBase).href));
첫 번째 /trigger만 실행되면 배열에는 /inbox/0 하나만 들어갈 수 있습니다.
/inbox/1까지 확인하려면 최소 두 번째 /trigger가 실행되어야 합니다.
따라서 다음 검증도 필요합니다.
assert.ok(measurement.requests.total > 1);이 코드는 측정된 요청이 적어도 2개 이상이어야 한다는 것입니다.
다만 이 조건은 ‘주소 생성이 올바르다’를 직접 확인하는 것이 아니라, 주소 두 개를 확인할 만큼 요청이 여러 번 실행됐는지에 대한 확인 절차입니다.
5. 왜 25ms가 문제가 되었을까?
이슈 본문에 적힌 내용에 따르면,
The test runs a closed-loop load plan for 25 ms with a concurrency of one. It then expects more than one request to have completed and checks that both alternating recipient inboxes were used:
typescriptassert.ok(measurement.requests.total > 1);Remote fault requests are serialized, and the load generator stops dispatching once the wall-clock deadline has passed. If the first asynchronous request or CI scheduling consumes most of the 25 ms window, the measurement contains only one request even though the failure runner is behaving correctly.
현재 코드의 설정은 다음과 같습니다.
load: { concurrency: 1 },
duration: "25ms",
concurrency: 1은 동시에 진행하는 작업을 한 개로 제한하는 폐쇄 루프 방식입니다.
첫 작업이 끝나야 다음 작업으로 넘어가는 방식이라는 것입니다.
Fedify 공식 문서에서도 폐쇄 루프를 ‘고정된 수의 가상 사용자가 작업하는 방식’으로 설명하고 있고,
원격 결함 전달은 대상의 큐 결과를 관찰(Monitoring)하면서 직렬화한다고 설명합니다.
Fedify can run as a cooperative benchmark target, and the fedify bench command drives ActivityPub-specific load against it to measure federation workloads without requiring an external metrics backend.
fedify.dev말이 어려울 수 있어서 정리해보자면, 정해진 인원의 가상 유저들이 계속해서 작업을 반복하는 통제된 테스트 환경에서, ‘상대방 서버가 갑자기 다운되면 내 서버가 어떻게 반응하는지’에 대한 장애 실험을 진행합니다.
이때 상대방 서버가 죽어서 보내지 못한 메시지들은 대기열(Queue)에 쌓이게 되는데, 내 서버는 이 대기열의 상태를 실시간으로 지켜보면서 작업이 서로 엉키거나 순서가 뒤바뀌지 않도록 한 줄로 바르게 세워(직렬화) 차례대로 재시도하거나 안전하게 삭제 처리합니다.
이제 CI가 바쁘다고 가정해 보겠습니다.
- 시작 0ms → 첫 번째 요청 실행 : /inbox/0
- 시작 5ms → 첫 번째 비동기 작업 대기
- 시작 25ms → 실행 시간 종료
- 시작 35ms → 첫 번째 작업 완료, 두 번째 요청은 시작하지 않음
이 경우 러너는 올바르게 동작했어도 결과는 이렇습니다.
measurement.requests.total = 1;
recipientInboxes = ["/inbox/0"];
그러면 requests.total > 1에서 실패합니다.
반대로 컴퓨터가 조금만 빨라서 첫 작업 후 25ms 안에 두 번째 요청을 시작하면 통과합니다.
이는 테스트가 코드의 오류 때문이 아니라 컴퓨터의 속도(환경)에 따라 성공과 실패가 갈리는 불안정한 테스트(Flaky Test)가 됩니다.
비록 재현은 힘들 것이라고 예상했지만, 실제 본인의 컴퓨터 환경에서도 테스트해 보았습니다.
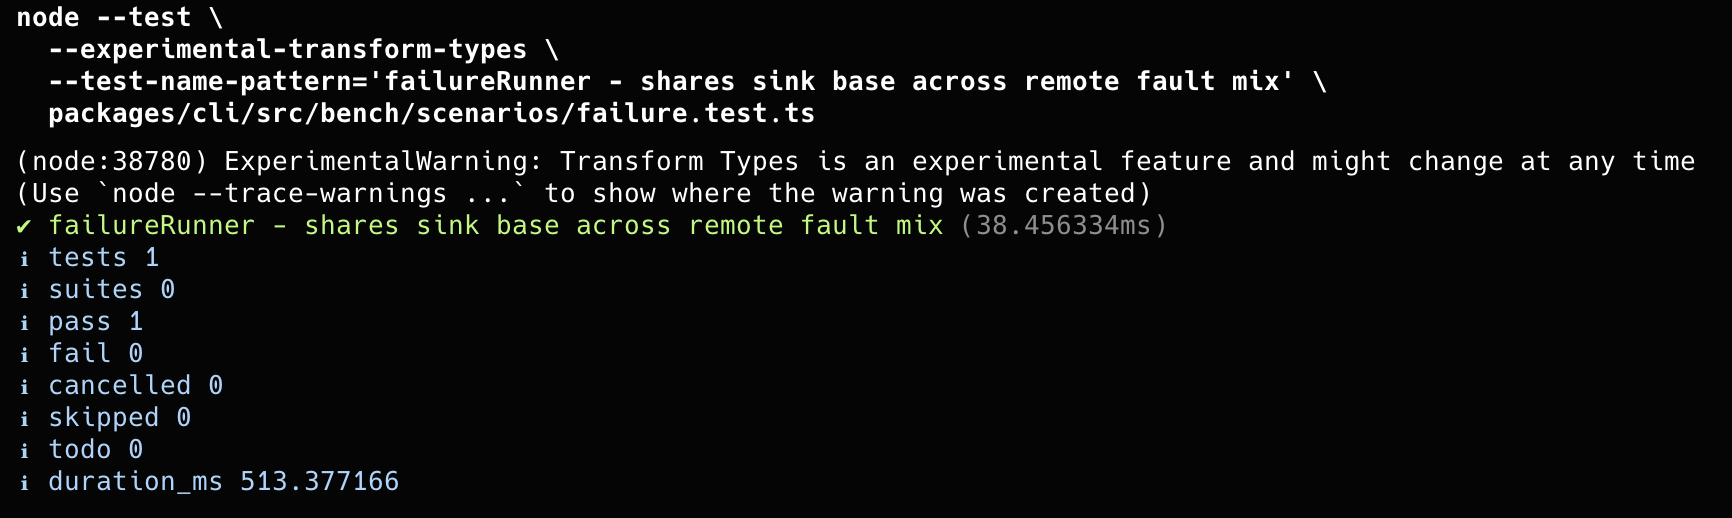
출력 결과를 보면, 테스트 자체가 실행된 시간(duration_ms)는 약 513ms지만, 해당 패턴의 실제 핵심 로직이 돌아간 시간은 약 38ms입니다.
정상적으로 테스트가 진행되었고, 100회 시도에도 이상은 없었습니다.
결론적으로 로컬 환경이 CI보다 빨라서 25ms 안에 끝났을 가능성이 높아서 발생하지 않았지만, #949의 Node.js 테스트 작업에서 실패한 사례가 있었기 때문에 이것이 Flaky Test의 무서운 점입니다.
→ ‘이 주제에 대해서는 추후에 다뤄보고 싶다.’
6. 어떻게 고치면 될까?
이 테스트의 본질은 ‘25ms 안에 몇 번 실행되느냐?’가 아니라 ‘두 결함을 실행했을 때 주소가 같은 sinkBase 아래에서 만들어지냐?’입니다.
따라서 두 번의 요청이 실행될 조건을 먼저 보장해야 합니다.
이슈 본문에서 명시된 접근 방식 제안(Suggested approach)을 바탕으로 해결 방안을 얻을 수 있었습니다.
- 가상 시계 주입 : 테스트가 시간을 통제해, CI가 느리더라도 두 요청을 관찰하기 전에 25ms 마감 시각이 지나지 않게 합니다.
- 실행 횟수 고정 : 러너가 횟수 모드를 지원한다면(ex.
runs: 2oriterations: 2), ‘25ms 동안 실행’ 대신 시간 상관 없이 ‘두 요청 실행’으로 테스트합니다.
‘어? 근데 그냥 duration: "25ms"를 duration: "1000ms"로 해서 여유롭게 가져가면 되는 거 아닌가?’라고 할 수 있지만, 이는 이슈 본문에서도 우려했던 내용이고, 실패 빈도를 줄일 뿐, 호스트 부하에 의존하는 문제를 본질적으로 해결하지 못합니다.
구현에 대한 설명
test("failureRunner - shares sink base across remote fault mix", async () => {
  const target = new URL("http://target.test/");
  const sinkBase = `http://127.0.0.1:${await reservePort()}/`;
  const scenario = normalizeSuite({
    version: 1,
    target: target.href,
    scenarios: [
      {
        name: "failure",
        type: "failure",
        fault: ["remote-404", "remote-410"],
        sender: "alice",
        sinkBase,
        load: { rate: 100 },
        duration: "25ms",
        queueDrainTimeout: "1s",
      },
    ],
  }).scenarios[0];
  // ...
});
시나리오 설정
코드에서 target은 테스트 대상의 기준 URL입니다.
이 테스트에서는 실제 대상 서버로 요청을 보내는 대신 fetch를 주입해 /stats와 /trigger 응답을 가짜로 돌려줍니다.
따라서 http://target.test/는 요청 URL을 구성하고 구분하는 기준 역할을 합니다.
reservePort()로 만든 sinkBase는 http://127.0.0.1:port/ 형태입니다.
핵심은 두 recipient inbox 각각 new URL("/inbox/0", sinkBase)와 new URL("/inbox/1", sinkBase)에 해당하는지 확인할 수 있다는 점입니다.
normalizeSuite() 함수는 테스트 러너(Test Runner)가 일반적으로 이해할 수 있는 하나의 통일된 내부 데이터 구조로 변환해 주는 함수입니다.
suite에서 failure 시나리오를 가져오는데, 설정의 의미는 다음과 같습니다.
| 설정 | 이 테스트에서의 역할 |
|---|---|
fault: ["remote-404", "remote-410"] |
두 원격 결함 유형을 섞어 실행 |
sender: "alice" |
trigger 요청에 사용할 발신자 |
sinkBase |
두 inbox URL의 공통 기준 주소 |
load: { rate: 100 } |
초당 100건의 예정 도착률 (open-loop) |
duration: "25ms" |
예정 도착 시각을 생성할 구간 |
queueDrainTimeout: "1s" |
큐 결과를 기다리는 경로의 제한 시간 설정 |
이 시나리오의 흐름을 정리하면,
http://target.test/를 대상으로 ‘alice’라는 가상 사용자가 보내는 활동에 대해remote-404,remote-410결함을 섞어 시험하고, 두 결함에 사용할 수신함을 동일한sinkBase아래에 만들면서, 초당 100건의 부하를 25ms 구간에 설정한 failure 시나리오를 정규화해 꺼냅니다.
가상 시계로 시간 의존성 제거
기존 테스트는 duration: "25ms" 동안 두 건 이상의 요청이 완료되도록 하는 방식이었습니다.
하지만 CI 처리가 많아지면, 첫 비동기 요청을 처리하는 사이에 duration이 지나서 러너가 정상적으로 동작해도 요청이 한 건만 측정될 수 있었습니다.
이를 피하기 위해 테스트에 Clock을 추가했습니다.
let now = 0;
const clock: Clock = {
  now: () => now,
  sleepUntil: (timeMs) => {
    now = Math.max(now, timeMs);
    return Promise.resolve();
  },
};now()는 러너에게 테스트의 현재 시각을 알려줍니다.
sleepUntil(timeMs)는 실제로 timeMs만큼 기다리지 않고, now 시각을 time까지 전진시킵니다.
이 시나리오는 rate: 100인 open-loop 부하를 사용하고, 기본 도착 분포인 constant에 따라 10ms 간격으로 요청을 예정합니다.
따라서 duration: "25ms" 구간의 예정 시각은 0·10·20ms, 총 세 개입니다.
30ms 이상부터는 구간 밖입니다.
Fedify can run as a cooperative benchmark target, and the fedify bench command drives ActivityPub-specific load against it to measure federation workloads without requiring an external metrics backend.
fedify.devassert.strictEqual(measurement.requests.total, 3);
assert.strictEqual(measurement.requests.total, triggerCalls);
assert.strictEqual(measurement.requests.failed, 0);
assert.ok(recipientInboxes.includes(new URL("/inbox/0", sinkBase).href));
assert.ok(recipientInboxes.includes(new URL("/inbox/1", sinkBase).href));assert.strictEqual(), assert.ok() 함수는 모두 기대 조건을 확인하는 단언 함수입니다.
조건이 맞으면 다음 줄로 진행하고, 맞지 않으면 오류를 던져 테스트를 실패시킵니다.
.strictEqual()은 파라미터의 두 값이 일치하는지 엄격하게 확인하고, .ok()는 값이 truthy한지 확인합니다.
즉, 위 코드에서 순서대로 측정하는 것들은 다음과 같습니다.
- 측정된 요청이 정확히 3건이어야 통과합니다.
- 3건의 요청 수와 mock이 관측한 trigger 호출 수가 같아야 합니다.
- 측정상 실패한 요청이 0건인지 확인합니다.
includes()는 해당 URL이 배열에 있으면true, 없으면false를 반환합니다. 즉,/inbox/0,/inbox/1이 각각 한 번 이상 지정됐는지 확인합니다.
후기(문제를 겪었던 경험)
이슈의 문제는 25ms짜리 closed-loop 테스트가 실제 시간 안에 두 번째 요청을 끝내지 못하면 total > 1 단언에서 실패한다는 것이었습니다. 이슈에서는 주입 가능한 Clock으로 시간을 통제하거나, 요청 횟수를 고정하는 방안을 제안했습니다.
now()는 현재 값을 읽고, sleepUntil()만 그 값을 앞으로 옮기는 방식은 가상 시계가 실제 시간이 지나도 저절로 움직이지 않습니다.
따라서 sleepUntil()을 호출하지 않는 기존 closed-loop 경로에 시계만 주입하면 25ms 종료 조건에 도달하지 못하는 문제가 발생합니다.
그래서 rate: 100을 지정해 open-loop로 바꿨습니다.
constant 분포에서는 요청 간격이 10ms면, 25ms 구간에 예정되는 시각은 0·10·20ms입니다. open-loop는 각 예정 시각에 sleepUntil()을 호출하므로 주입한 시계가 앞으로 갑니다.
하지만, 예정 시각이 세 개라는 사실만으로 요청 세 건이 측정됐다고 단정지을 수는 없습니다.
그래서 measurement.requests.total === 3을 확인하고, 그 값이 mock에서 관측한 /trigger 호출 수인 triggerCalls와도 일치하는지 검증했습니다.
결과적으로 제거한 것은 ‘CI의 실제 25ms 안에 두 번 이상의 요청이 완료되도록 해야 한다’는 조건입니다. 두 inbox가 모두 사용됐는지는 기존 단언으로 계속 검증합니다.
다음에는 테스트를 고치기 전에 실패한 단언이 무엇을 검증하고, 어떤 실행 조건에 의존하는지부터 보면 좋을 것 같습니다.